OCR.space 免费 OCR 接口:每月 2.5 万次额度如何申请与调用教程
免费额度
免费 API Key:25,000 次/月、单 IP 500 次/天,单文件 1MB、PDF 最多 3 页,另赠 1,000 次 Engine 3(200+ 语言);搜索版 PDF 带水印
注意事项
教程
OCR.space 的免费接口门槛很低:不用进控制台、不用开计费账户、也不用绑卡,一个邮箱就能拿到 API Key。整体流程是「在页面填邮箱 → 收邮件拿 key → 把 key 带进请求」。
- 找到申请入口:打开
https://ocr.space/ocrapi,页面中间位置有免费 API Key 的申请表单,只需要填写邮箱地址并勾选同意服务条款,不需要填公司信息。 - 提交后查收邮件:平台会把 API Key 直接发到你填写的邮箱,通常几分钟内到达;没收到先翻垃圾邮件和推广标签页,如果是国内邮箱长期收不到,换一个常用国际邮箱重新申请。
- 确认没有额外门槛:整个过程没有实名认证、没有信用卡验证,key 到手就能调用。免费额度为每月 25,000 次请求,同时限制同一 IP 每天 500 次。
- 看清引擎范围:免费 key 默认走 Engine 2,另外赠送 1,000 次 Engine 3(支持 200 多种语言)调用;赠送次数用完后 Engine 3 需要付费,剩余次数以控制台实际显示为准。
- 记住免费档的边界:单个文件不超过 1MB,PDF 最多 3 页,搜索版 PDF 输出带平台水印。长文档和成批扫描件不适合放在免费额度里跑。
拿到 key 后建议立刻存进密码管理器或环境变量,不要直接写进前端代码——key 泄露后消耗的是你自己的月度额度,而且单 IP 每天 500 次的上限很容易被别人打满。
这个平台不提供对话补全,只有一个图像解析地址,所有调用都是向它 POST 文件或图片地址。
base_url 形态固定为 https://api.ocr.space/parse/image,没有版本号区分,也没有区域节点。所谓「模型」就是 OCREngine 参数:1 轻量、2 为默认、3 精度最高但消耗赠送额度。
用 curl 发一次识别请求
key 通过请求头 apikey 传递(也可以放在表单字段里),文件用 file 字段上传,同时指定语言、引擎与表格解析。
export OCR_API_KEY="替换为邮件里收到的密钥"

curl -X POST https://api.ocr.space/parse/image \
  -H "apikey: $OCR_API_KEY" \
  -F "file=@invoice.jpg" \
  -F "language=chs" \
  -F "isTable=true" \
  -F "OCREngine=2"
用 Python 读取识别文本
返回是一段 JSON,正文在 ParsedResults[0].ParsedText 中,出错时重点看 IsErroredOnProcessing 与 ErrorMessage。
import requests

api_key = "替换为邮件里收到的密钥"

with open("invoice.jpg", "rb") as f:
    resp = requests.post(
        "https://api.ocr.space/parse/image",
        headers={"apikey": api_key},
        files={"file": f},
        data={"language": "chs", "isTable": "true", "OCREngine": "2"},
        timeout=60,
    )

result = resp.json()
if result.get("IsErroredOnProcessing"):
    print(result.get("ErrorMessage"))
else:
    print(result["ParsedResults"][0]["ParsedText"])
关键参数说明
file/url/base64Image:三种入参任选其一,本地文件上传、图片直链、Base64 数据都支持。language:指定识别语言,简体中文用chs,英文用eng;Engine 3 覆盖 200 多种语言,具体代码见官方文档。isOverlayRequired:设为true时返回每个词的坐标,适合版面还原和字段定位。isTable:设为true时按行解析表格,发票、票据类识别比纯文本更可靠。filetype:上传 PDF 时用来声明类型,不确定可交给接口自动判断。
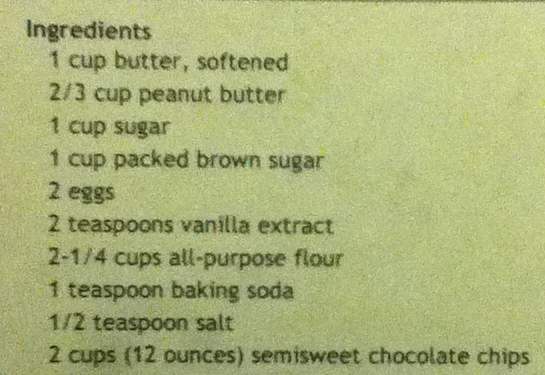
下图是平台对配料表这类图片的识别结果示例,正文与坐标会一起返回:
PDF 与多页文档
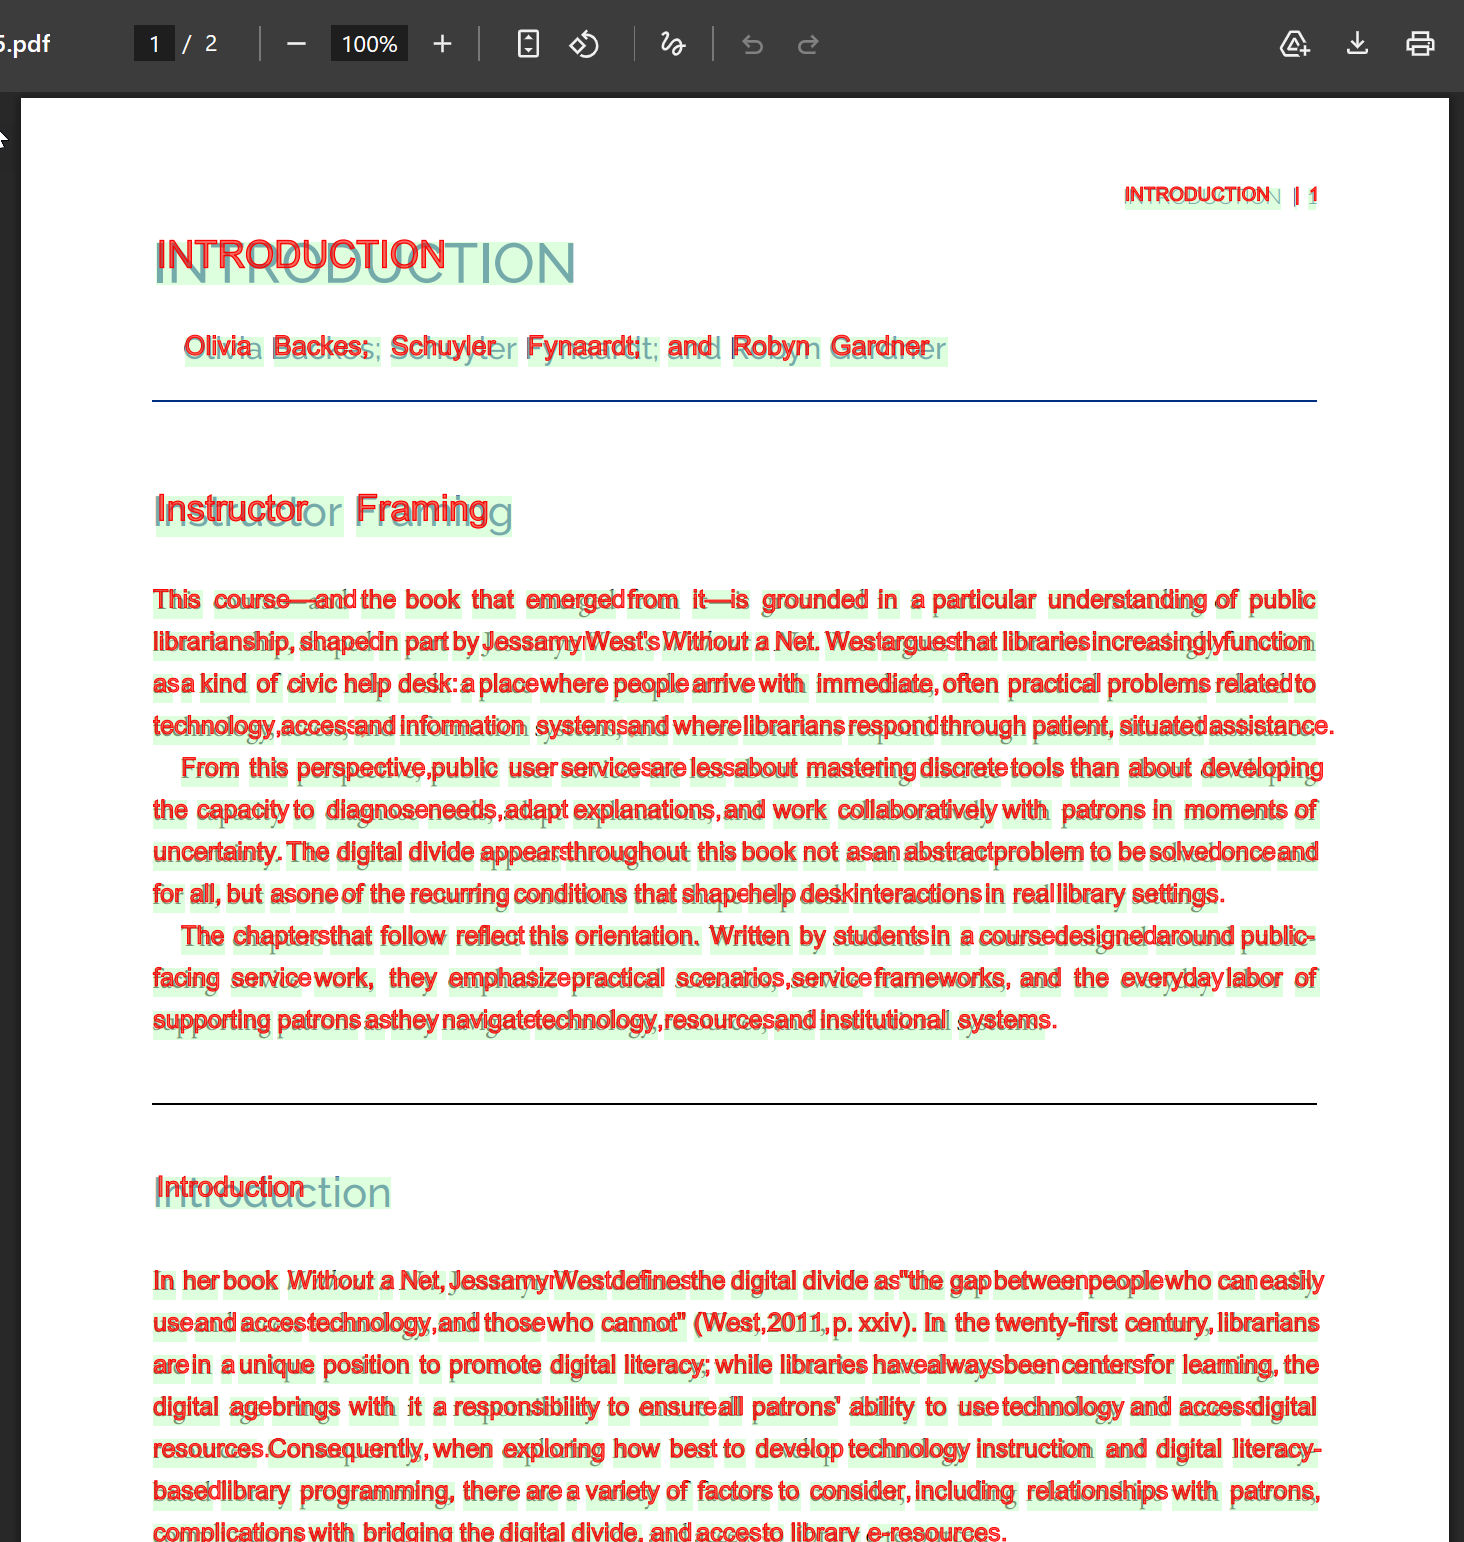
免费档在 PDF 上限制最明显:单文件 1MB 以内、最多处理 3 页,超出部分不会识别;搜索版 PDF 输出还会带平台水印。下图展示的就是可搜索 PDF 的输出形态:
额度耗尽与限流怎么排查
触发限流或超限时,HTTP 状态码往往仍是 200,但 JSON 里 IsErroredOnProcessing 会变成 true,ErrorMessage 会写明具体原因,常见的是超出 24 小时内 500 次上限、文件过大或页数超限。建议按下面的顺序逐一排查:
- 先打印完整响应体,读
ErrorMessage原文,不要只看 HTTP 状态码就判断调用失败。 - 核对
apikey是否拼写正确,是否被复制时带进了空格或换行。 - 统计当天调用量:单 IP 每天 500 次是硬上限,多台机器共用一个出口 IP 时很容易提前打满。
- 检查文件是否超过 1MB、PDF 是否超过 3 页,必要时压缩图片或先把文档拆分。
- 确认是否误用了 Engine 3 且赠送的 1,000 次已经用完,切回 Engine 2 即可继续调用。
如果确实需要更高并发或更长文档,只能考虑升级付费套餐。免费档的额度和限制会随官方调整,具体数值以官网页面与控制台实际显示为准,不建议把关键业务完全押在免费额度上。
这个还能用吗?点一下告诉我们
只能从下方固定选项中选择,无法自由输入,避免垃圾信息与安全隐患。
留言区 0
真实访客可自由留言,提交后先经内容安全审核(本地 + 可选远程 API)再展示;违规内容会被拦截,不会出现在此处。示例留言均带「示例」标识,不冒充真实用户。